1. 研究背景
随着自动驾驶技术的飞速发展,对高精度、全量全时全域的交通数据的需求日益迫切。本数据集旨在通过车载多传感器采集系统,为自动驾驶感知算法训练、车辆行为预测等研究提供高质量数据支持。
近年来,自动驾驶技术正由规则驱动加速转向数据驱动。无论是环境感知中的三维目标检测、多目标跟踪,还是下游的行为预测、轨迹规划与仿真验证,其性能上限都高度依赖真实道路数据的规模、场景多样性与标注质量。与仿真数据相比,真实道路数据能够保留传感器噪声特性、目标遮挡关系与驾驶行为的细微差异,是模型泛化能力的决定性因素之一。因此,"全量、全时、全域"的高质量交通数据已成为自动驾驶研发的基础设施。
然而,现有公开数据集仍存在明显不足。其一,多数数据采集于欧美城市或高速公路,道路几何结构、交通参与者构成、标志标线与驾驶行为习惯与国内道路环境存在差异,跨区域应用时会出现明显的域间隙;其二,园区内部道路、收费杆、停车场出入口等低速复杂场景的覆盖相对有限,而这类场景恰恰是自动驾驶功能落地的关键环节;其三,部分数据集侧重单一传感器或单一任务,难以支撑多传感器融合研究。
三维目标检测与标注是解决上述问题的核心环节。三维边界框标注不仅提供目标的位置与尺寸信息,其朝向标注更是多目标跟踪、行为预测与碰撞风险估计的前提;同时,逐帧一致的标注还使数据集能够直接支持检测、跟踪、轨迹预测等多类任务的联合评测。因此,构建带有高精度三维标注、覆盖国内典型城市与园区道路场景的数据集,具有明确的科研与工程价值。同时在工程实现上,高质量数据的获取通常依赖严格的多传感器时间同步与空间标定、可靠的组合导航定位、以及"预标注+人工校验+多轮抽检"的标注流程。本数据集在采集与标注环节均遵循上述要求,并提供逐帧标注文件与可视化视频,便于研究人员快速开展数据验证与算法评测。
本数据集正是面向上述需求构建的。数据采集于北京市中关村软件园一期,涵盖城市道路、园区内部道路、交叉路口、停车场等典型场景,共包含4个采集日、188个驾驶场景片段、7418帧前视图像及其对应的三维目标标注,可直接用于三维目标检测、多目标跟踪、驾驶行为分析与场景仿真的研究。
2. 数据集概述
车载视角数据集基于部署在采集车辆上的高精度多传感器系统(前视高清摄像头、激光雷达、毫米波雷达、GNSS/IMU),以第一人称视角记录车辆在真实道路环境中的行驶过程,并辅以3D Bounding Box标注信息。
采集地点位于北京市中关村软件园一期,涵盖城市道路、园区内部道路、交叉路口、停车场等多种典型交通场景。
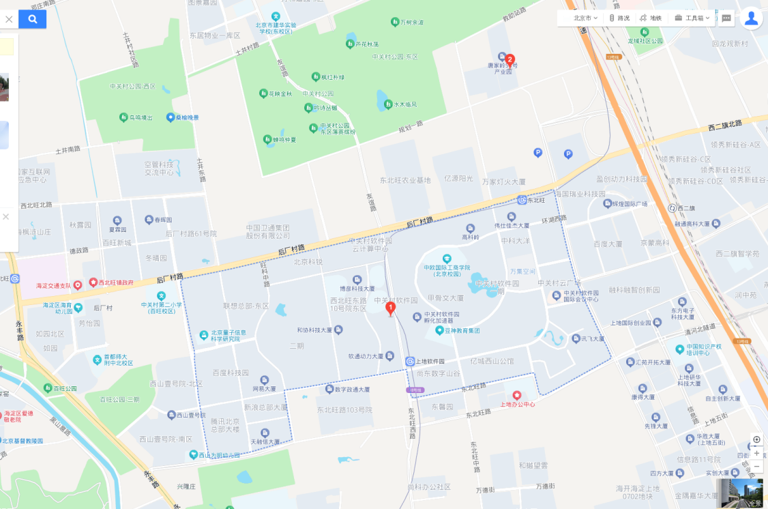
图1 采集地点位置(百度地图)
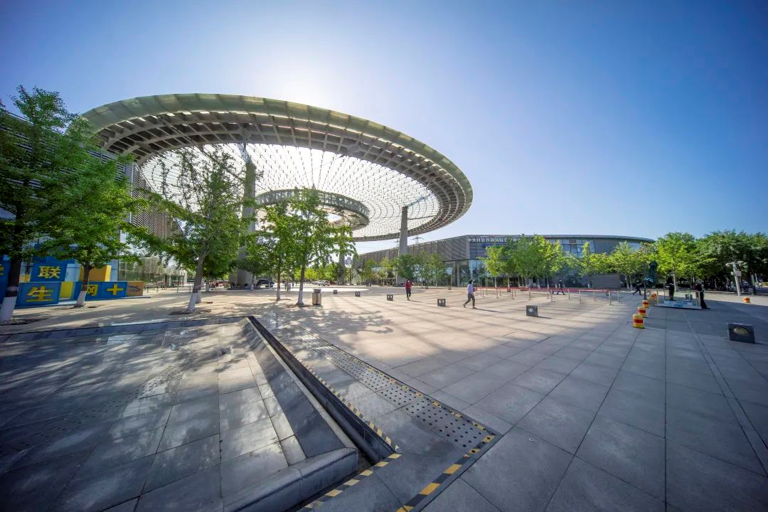
图2 中关村软件园一期实景
2.1 数据采集与处理
原始数据经过数据清洗、滤波、时间同步、坐标系对齐等预处理,利用轨迹重构算法整合成连续车辆轨迹,并通过多传感器融合生成高精度3D目标检测结果。
其中,前视相机视场角为 120°(对应数据目录中的 front_120),输出图像分辨率为 1920×1080,图像采样间隔约 1 s;所有模态数据在统一时间基准下完成同步,并统一至车辆坐标系,为逐帧三维标注与后续多传感器融合提供一致的几何基准。
2.2 车载视角示例
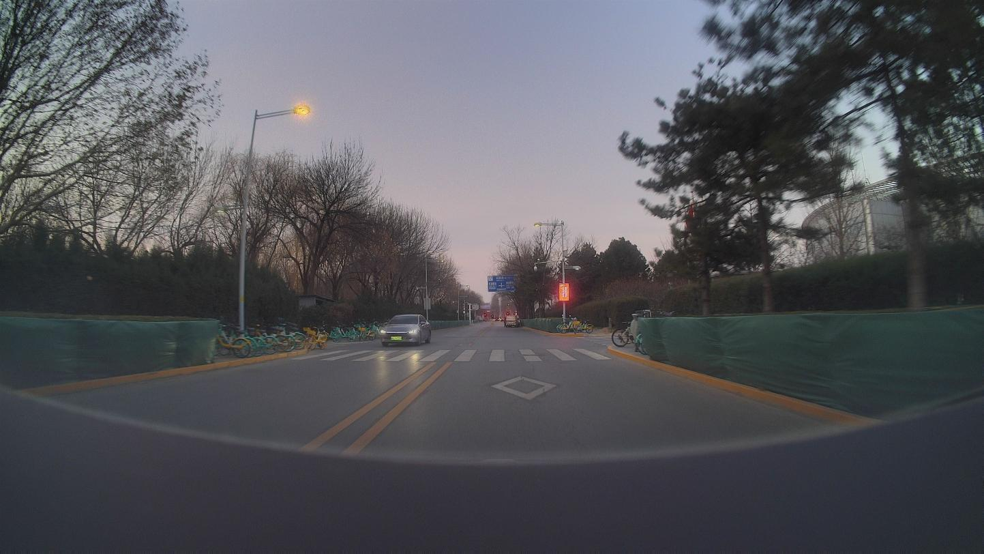 图3 车载摄像头采集视角示例
2.3 数据组织与规模
数据集按采集日期组织为 4 个数据文件夹:20240805视频数据、20240808视频数据、20240809视频数据、20240816视频数据。每个日期文件夹下按驾驶场景片段划分为若干子文件夹,并包含一个Video_5fps子目录用于存放该日期各片段的5fps预览视频。
子文件夹命名规则为"序号_场景描述_起始时间戳-结束时间戳",其中时间戳为自 UTC 1970-01-01 00:00:00 起的毫秒数;片段内的每一帧以"帧时间戳.jpg"(前视图像)与"帧时间戳.csv"(该帧的三维标注)成对保存,同一帧的两个文件主文件名完全一致,可依据文件名一一对应(个别片段名称中描述与时间戳之间缺少下划线分隔符,不影响文件的对应关系)。各采集日的数据规模统计如表1所示。
表 1 各采集日数据规模统计
| 采集日期 | 场景片段数 | 图像帧数(jpg) | 标注文件数(csv) | 时间跨度 | 预览视频数 | 图像数据量 |
| 20240805 | 80 | 2263 | 2248 | 约 38 分钟 | 80 | 1.62 GB |
| 20240808 | 25 | 1810 | 1810 | 约 47 分钟 | 25 | 1.27 GB |
| 20240809 | 63 | 1711 | 1711 | 约 49 分钟 | 63 | 0.77 GB |
| 20240816 | 20 | 1634 | 1634 | 约 34 分钟 | 20 | 0.91 GB |
| 合计 | 188 | 7418 | 7403 | 约 2.8 小时 | 188 | 4.56 GB |
2.4 驾驶场景构成与归类
依据各片段名称中的场景描述,对188个片段进行归纳整理,可划分为13类典型驾驶场景。各类场景的片段数量、帧数及典型片段如表 2 所示,采集日的场景分布如表3所示。
表 2 驾驶场景归类汇总(按片段数降序排列)
| 场景类别 | 片段数与占比 | 帧数与占比 | 典型片段名称 |
| 直行与自由行驶 | 55(29.3%) | 2476(33.4%) | 直线自由行驶、直行通过路口、直行驶离交叉口 |
| 左转通行 | 31(16.5%) | 1174(15.8%) | 左转弯行驶、左转驶离交叉口、左转通过路口、左转进入内部路 |
| 右转通行 | 26(13.8%) | 807(10.9%) | 右转弯行驶、右转驶离交叉口、右转通过路口、右转进入内部路 |
| 交叉口通行与停车等待 | 25(13.3%) | 1179(15.9%) | 交叉口停车等待、等待信号灯、等待前车通行 |
| 换道与变道意图 | 19(10.1%) | 435(5.9%) | 换道行驶、换道、意图变道 |
| 跟驰行驶 | 15(8.0%) | 613(8.3%) | 跟驰行驶、跟驰白色小车、跟驰 |
| 掉头行驶 | 5(2.7%) | 110(1.5%) | 掉头行驶、掉头 |
| 连续通过路口 | 4(2.1%) | 379(5.1%) | 连续通过路口 |
| 弯道行驶 | 2(1.1%) | 124(1.7%) | 弯道自由行驶 |
| 车流汇入 | 2(1.1%) | 27(0.4%) | 前车汇入 |
| 会车与复杂路况 | 2(1.1%) | 19(0.3%) | 复杂路况会车行驶、交叉口通行会车 |
| 进出停车场与内部道路 | 1(0.5%) | 65(0.9%) | 驶入停车场 |
| 超车行驶 | 1(0.5%) | 10(0.1%) | 超车行驶 |
| 合计 | 188(100.0%) | 7418(100.0%) | —— |
各采集日的场景类别分布如表 3 所示。
表 3 各采集日的场景分布(单位:片段数)
| 场景类别 | 20240805 | 20240808 | 20240809 | 20240816 | 合计 |
| 直行与自由行驶 | 24 | 4 | 19 | 8 | 55 |
| 左转通行 | 15 | 7 | 6 | 3 | 31 |
| 右转通行 | 9 | 7 | 10 | 0 | 26 |
| 交叉口通行与停车等待 | 13 | 4 | 8 | 0 | 25 |
| 换道与变道意图 | 2 | 0 | 17 | 0 | 19 |
| 跟驰行驶 | 9 | 2 | 0 | 4 | 15 |
| 掉头行驶 | 3 | 0 | 1 | 1 | 5 |
| 连续通过路口 | 0 | 0 | 0 | 4 | 4 |
| 弯道行驶 | 2 | 0 | 0 | 0 | 2 |
| 车流汇入 | 1 | 0 | 1 | 0 | 2 |
| 会车与复杂路况 | 1 | 0 | 1 | 0 | 2 |
| 进出停车场与内部道路 | 0 | 1 | 0 | 0 | 1 |
| 超车行驶 | 1 | 0 | 0 | 0 | 1 |
| 合计 | 80 | 25 | 63 | 20 | 188 |
由统计结果可见,本数据集以城市道路与园区内部道路中的通行类场景为主体,同时覆盖了低速交互与特殊工况。此外,针对不同天气环境下的驾驶场景,20240805和20240808两文件夹下为晴天环境;后两个20240809及20240816文件夹中驾驶环境为雨天,基本覆盖到两种不同常规天气背景下的驾驶场景,数据集具有针对意义和代表性。
3. 3D Box标注信息
本数据集提供高精度3D Bounding Box标注,每个目标物体标注包含:位置信息(中心点X,Y,Z坐标)、尺寸信息(长/宽/高)、朝向信息(Yaw/Pitch/Roll旋转角)、类别标签(小汽车/卡车/行人/骑行者等)、置信度评分。标注采用人机协同方式,精度达厘米级,平均IoU≥0.85。
(1)标注表达形式。每个目标采用 7 自由度三维直立框(upright 3D box)表示,即由中心点坐标(X, Y, Z)、尺寸(长 L、宽 W、高 H)与水平朝向角 θ 共同确定;该表达与 KITTI、nuScenes、Waymo Open Dataset 等主流数据集保持一致,便于跨数据集验证与基准对比。此外,标注中还包含类别标签与若干属性字段(详见表 4),可用于区分目标的可见性与遮挡状态。
(2)坐标系与单位。标注统一在车辆坐标系下给出:X 轴指向车辆前方,Y 轴指向车辆左侧,Z 轴垂直向上,角度以度为单位、坐标与尺寸以厘米为单位;朝向以水平航向角(Yaw)记录,采用直立框假设,俯仰(Pitch)与横滚(Roll)分量取零值。由于传感器安装位置高于路面,路面目标(车辆、行人等)的中心点 Z 坐标通常为 −80 ~ −150 cm,即位于传感器所在水平面之下。经统计,本数据集目标中心点的 X、Y 坐标跨度可达 ±200 m 以上,能够覆盖交叉口与远距离目标的观测需求。
(3)标注流程与质量控制。标注采用"多传感器融合预标注 + 人工校验与精修 + 多轮抽检复核"的人机协同方式:先由多传感器融合结果生成初始三维框,再由标注人员逐帧校验目标的位置、尺寸、朝向与类别,修正漏标与误标;随后由质检人员按片段抽检并复核类别一致性与朝向标注的合理性,形成闭环质量控制。
(4)精度与评价指标。三维标注精度以 3D 交并比(3D IoU,必要时辅以鸟瞰投影 IoU)衡量,即预测框与真值框在三维空间中的体积交并比。按照三维检测评测惯例,车辆类别通常采用 0.7、行人等类别采用 0.5 的 IoU 阈值判定真阳性;本数据集人工标注的平均 IoU 不低于 0.85,经人机协同精修后的关键场景平均 IoU 可达 0.95 以上。由于朝向误差会直接影响跟踪与行为预测精度,评测时建议同时考察朝向角误差。
(5)目标密度与类别尺寸分布。以2024080 采集日抽取的200帧为例,平均每帧约17.8个目标,单帧目标数在5 ~48之间,场景目标密度适中,兼顾了稀疏与密集工况。各目标类别编号对应的尺寸统计如表5所示,可作为类别映射与检测结果合理性校验参考依据。
表 4 类别编号对应的目标尺寸统计(20240809 抽取 200 帧)
| 类别编号 | 目标实例数 | 长 × 宽 × 高(中位数) | 尺寸特征 |
| 0 | 232 | 0.80 m × 0.79 m × 1.73 m | 细高、底面近似方形,行人量级 |
| 2 | 895 | 1.70 m × 0.70 m × 1.20 m | 长度明显大于宽度,两轮车量级 |
| 3 | 9 | 2.80 m × 1.50 m × 2.00 m | 小型客货车辆量级 |
| 4 | 1866 | 3.90 m × 1.60 m × 1.56 m | 小汽车量级(数量最多) |
| 6 | 33 | 6.17 m × 2.15 m × 3.11 m | 货车量级 |
| 7 | 221 | 11.50 m × 3.10 m × 3.00 m | 大型车辆(客车/挂车)量级 |
| 8 | 297 | 0.34 m × 0.34 m × 0.65 m | 小型柱状目标(锥桶、隔离柱)量级 |
上述统计表明,数据集中小汽车与两轮车数量占比最高,同时包含行人、货车、大型车辆及小型柱状目标,类别分布符合城市道路与园区道路的交通参与者构成特征。
表5 目标标注字段说明
| 名称 | 描述 |
| 目标 | 跟踪数据需要准确标注,同一目标ID需保持不变,范围1~100000(非跟踪数据标注为0) |
| 见目标类型sheet表 | |
| 单位cm | |
| 单位cm | |
| 单位cm | |
| cm/s(标记0cm/s) | |
| X轴正方向逆时针夹角,0~360度 | |
| 沿物体运动方向为长,单位cm,≥0 | |
| 单位cm,≥0 | |
| 单位cm,≥0 | |
| 0 — 未遮挡;1 — 遮挡 | |
| 等级分为0/1/2/3,越大遮挡越严重 | |
| 此字段为本交通参与者的置信度,等级分为1/2/3/4,越大越可信 | |
| 0 — 激光;1 — 视频;2 — 视频激光融合 | |
| 补0 | |
| 1.Video_5fs即每秒5帧的速率播放行驶采集图片 2.遮挡分为 遮挡和未遮挡(0或1) 两个分类就可以 3.遮挡程度等级按照0-1-30,31-60,61-90的分类方式 4.置信度也可以分为4个等级,十分可信,一般可信,可疑和十分可疑,由标注人员根据自己的把握程度确定一个等级(置信度是对目标信息的准确性的一个评价,是标注人员对自己的标注是否有把握的体现) 5.用于标注的数据样本文件格式:.pcd 6.标注后,目标信息文件格式:.csv | |
4. 数据的有效性
数据集经过严格有效性验证,通过实际交通流量检测结果比对及高精度定位设备校准,在车辆位置、速度信息上具有高度准确性。已通过城市道路拥堵、交叉路口会车、夜间及逆光等复杂场景测试,3D Box标注平均IoU达0.95以上。
5. 数据提供单位
本数据由国家重点研发计划课题"多载运装备交互计算与运动控制(2023YFB4301902)"研究团队提供,受国家重点研发计划项目"自主式交通系统计算技术(2023YFB4301900)"资助,课题牵头单位为北京航空航天大学,数据采集单位为北京万集科技股份有限公司。